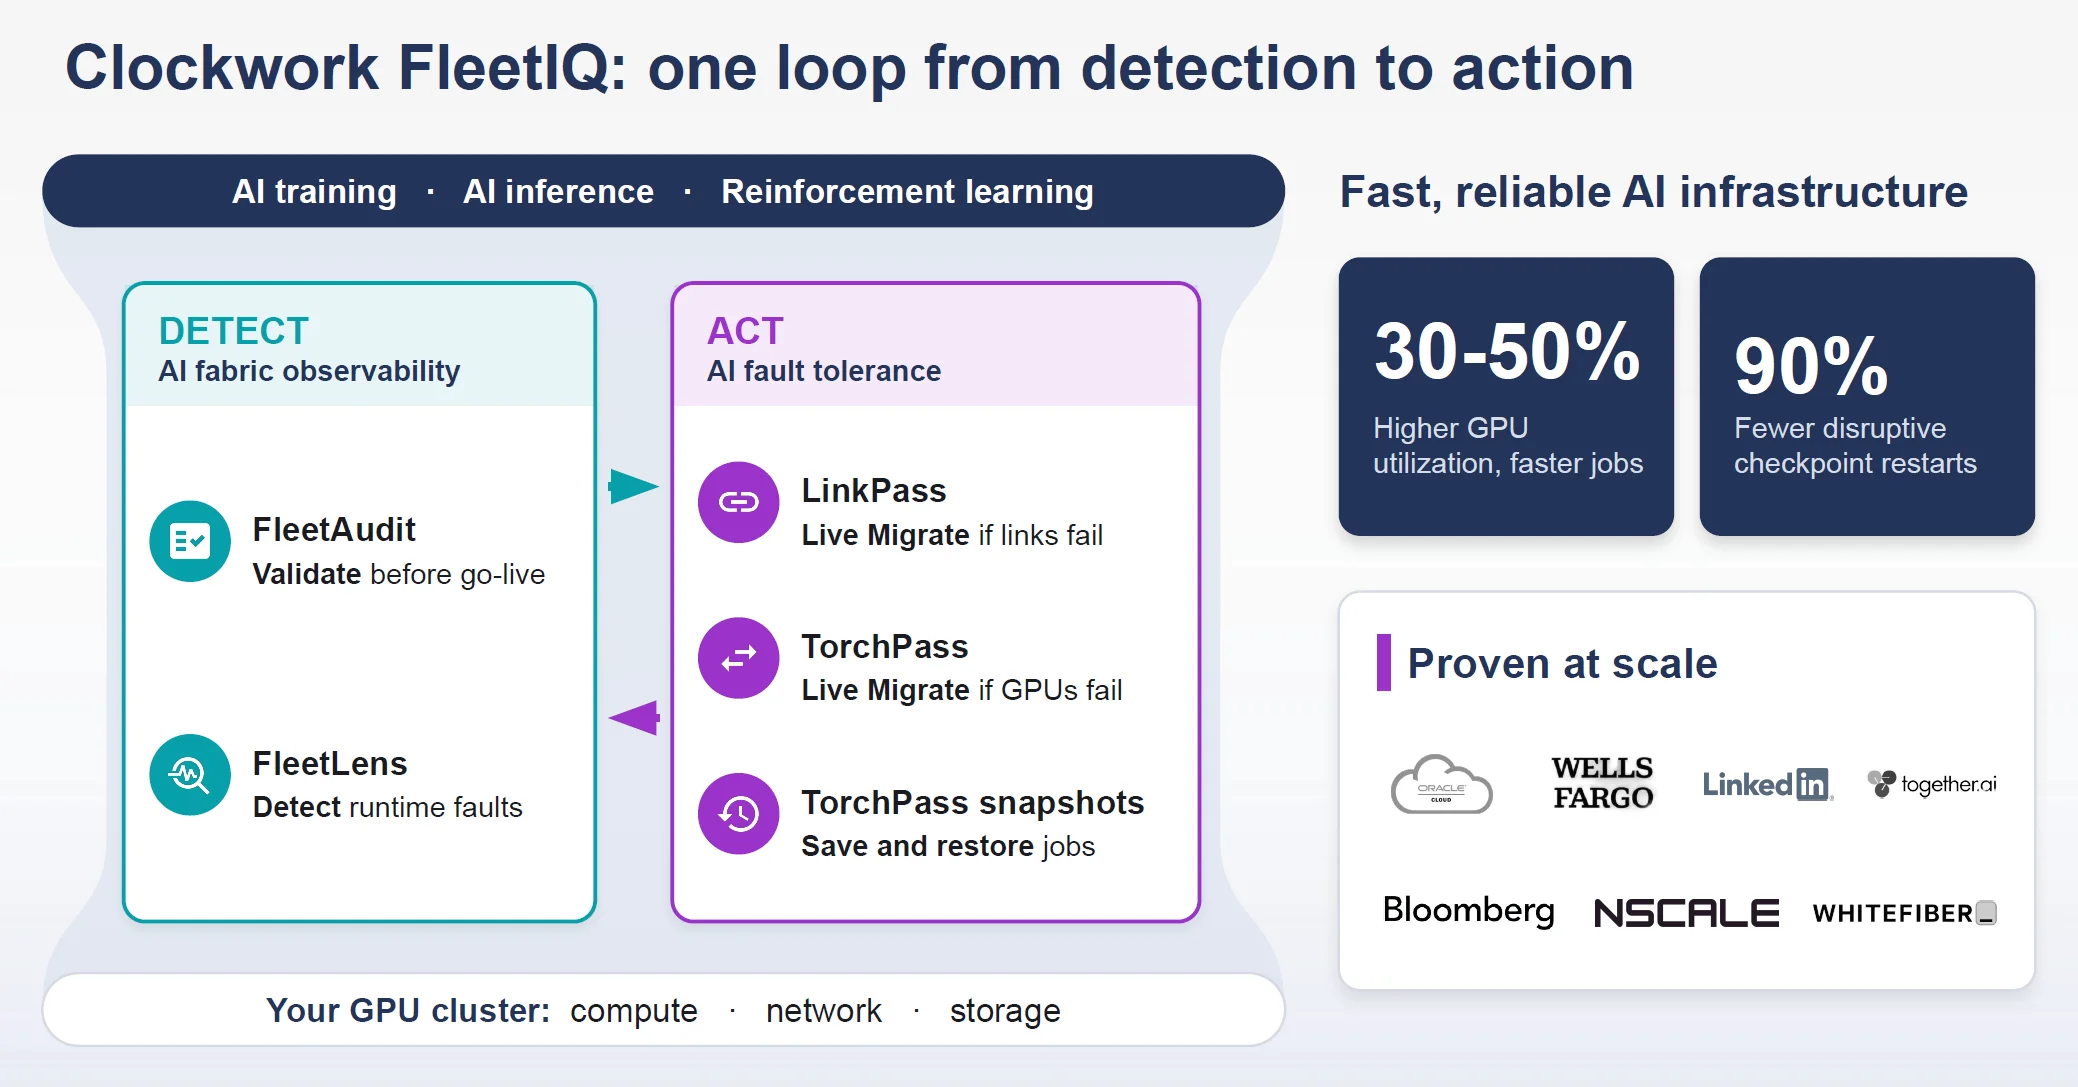
Auf der IT Press Tour kappte Clockwork.io Netz- und Stromverbindungen eines laufenden Trainingsjobs. Laut Unternehmen halten LinkPass und TorchPass solche Jobs am Laufen; 31 Millionen US-Dollar finanzieren den Ausbau.
Fällt bei einem KI-Training eine einzelne GPU oder Netzwerkverbindung unter Tausenden aus, steht meist der gesamte Job still. Clockwork.io will solche Fehler per Software abfangen. Auf der IT Press Tour zeigte das Unternehmen live, wie das funktionieren soll: Ingenieure zogen bei einem laufenden Training ein Netzwerkkabel und anschließend ein Stromkabel.
Was Ausfälle im großen Maßstab kosten
Große Trainingsjobs laufen im Gleichschritt, deshalb legt eine ausgefallene Verbindung, eine überhitzte GPU oder ein abgestürzter Knoten alle Beteiligten lahm. CEO Suresh Vasudevan verwies auf eine Meta-Studie, die für Jobs mit 1.024 GPUs eine mittlere Zeit bis zum Ausfall von 7,9 Stunden nennt, und auf eine ByteDance-Studie, nach der 42,5 Prozent der Jobs wegen Nachzüglern mindestens zehn Prozent langsamer liefen. Nach einem Absturz müssen Teams den Fehler lokalisieren, was von Hand ein bis drei Stunden dauern kann, den Job neu starten, den letzten Checkpoint laden und verlorene Arbeit neu berechnen.
Von der Uhrensynchronisation zur Fehlertoleranz
Das Unternehmen ging aus einem Stanford-Projekt zur Uhrensynchronisation hervor, geleitet von Balaji Prabhakar und Yilong Geng; VMware-Gründer Mendel Rosenblum war früh beteiligt. Laut Unternehmensangaben erreicht die Software ohne Spezialhardware eine Genauigkeit im zweistelligen Nanosekundenbereich und gewann damit Finanzkunden wie Nasdaq und Wells Fargo. Seit 2022 dienen dieselben Uhren der Netzwerktelemetrie in GPU-Clustern; die Plattform FleetIQ ist seit September 2025 allgemein verfügbar.
Drei Schutzschichten
Zuerst greift LinkPass, ein NCCL-Plugin. Fällt eine Netzwerkkarte aus, leitet es den Verkehr samt Paketen im Flug auf die intakten Karten desselben Hosts um und schaltet zurück, sobald die Verbindung wieder steht. Die Erkennung dauert Hunderte Millisekunden, der gesamte Wechsel ein bis zwei Sekunden; der NCCL-Transport-Timeout liegt dagegen bei etwa einer Minute, der PyTorch-Standard bei zehn Minuten. In der Demo führte das gezogene Kabel bei einem Zwei-Knoten-Job nur zu einem kurzen Einbruch, der Schrittzähler lief weiter, nach dem Wiederanstecken verteilte sich der Verkehr erneut auf alle vier Karten. Die Demo lief live im Labor des Unternehmens, nicht als Aufzeichnung. Vasudevan beziffert den Anteil linkbedingter Ausfälle auf 15 bis 20 Prozent. LinkedIn berichtet von Zehntausenden eingesparten GPU-Stunden pro Monat, Oracle bettet LinkPass in seine Cloud ein. Chief Business Officer Dan Zheng nannte einen betrieblichen Vorteil: Switch-Wartungen erforderten bislang, Jobinhaber vorab zu warnen, damit diese Checkpoints schreiben, sie lassen sich nun unabhängig von den Jobs durchführen.
TorchPass deckt ausfallende GPUs und Knoten durch Live-Migration auf einen Ersatzknoten ab, was Vasudevan mit vMotion verglich. Es bringt den Job an einem konsistenten Punkt zum Stillstand, fordert beim Scheduler (Kubernetes, Slurm und Varianten) Ersatz an und überträgt den Zustand. Bei plötzlichen Ausfällen rekonstruiert es den Zustand aus einem datenparallelen Replikat, das daher vorhanden sein muss. Als das Team einem Knoten den Strom kappte, pausierte der Job rund eine Minute bei Schritt 5.040 und lief am selben Schritt weiter. Reserven machen typischerweise fünf bis acht Prozent eines Clusters aus und führen bis zum Bedarf niedrig priorisierte Arbeit aus. Über Ausfälle hinaus kann die Migration Jobs auch für Sicherheits-Patches oder zum Entfernen von Nachzüglern von Knoten holen und auf Warnungen wie steigende GPU-Temperaturen reagieren.
Die dritte Schicht, als erste Multi-Node-Plattform-Snapshots der Branche angekündigt, sichert CPU- und GPU-Zustand ohne Codeänderungen. Laut Unternehmen dauern sie unter 20 Sekunden und kosten bei 25-Minuten-Intervall rund ein Prozent, benötigen aber viel Speicher; Wiederherstellungszeiten wurden noch nicht gemessen. Together AI plant, LinkPass und TorchPass als Service für seine Kunden anzubieten, Snapshots sollen folgen.
Zahlen mit Vorsicht lesen
In einem Firmen-Benchmark benötigte ein Llama-4-MoE-Modell auf 64 GPUs ohne Fehler etwa 400 Minuten. Mit stündlich injizierten Ausfällen waren es mit TorchPass ebenfalls etwa 400, mit Checkpoint-Restart etwa 800 Minuten. Der ClusterMAX-Rechner von SemiAnalysis zeigt bei Standardwerten für einen 4.096-GPU-Cluster, dass der Goodput-Verlust in einer Gold-Stufe von 13,7 auf 2,8 Prozent sinkt, in einer Silber-Stufe von 28,5 auf 10,3 Prozent. Es handelt sich um Szenarien des Herstellers, nicht um Feldmessungen.
Observability und Geschäftsmodell
FleetLens sendet alle zehn Millisekunden Sonden zwischen allen Netzwerkkartenpaaren und misst mit synchronisierten Uhren die einseitige Verzögerung. Triangulation benennt dann die fehlerhafte Verbindung oder schließt das Netzwerk aus. FleetAudit nutzt dies vor der Übergabe; WhiteFiber validiert damit Cluster und spricht von Minuten statt Tagen an Tests. In einem Pilotprojekt bei einer großen GPU-Cloud wirkten über 30 bis 60 Sekunden gemittelte Switch-Zähler unauffällig, während die Sonden eine fehlerhafte Verbindung zwischen Leaf und Spine aufdeckten, die einen einzelnen Job betraf.
Abgerechnet wird pro GPU und Jahr. Neoclouds kaufen direkt, Unternehmen kommen zunehmend über Partner wie Together AI. Unterstützt werden NVIDIA- und AMD-GPUs sowie InfiniBand und RoCE, nicht jedoch TPUs und Trainium. Den Hauptwettbewerber sieht Vasudevan in hauseigenen Checkpoint-Restore-Lösungen und sagte, das Unternehmen schreibe Kunden Gutschriften gut, wenn weniger als 90 Prozent der Ausfälle ohne Neuberechnung aufgefangen werden. Eine mit 31 Millionen US-Dollar ausgestattete Runde unter Führung von Premji Invest, Wing und Seligman Ventures hebt die Gesamtfinanzierung auf 73 Millionen US-Dollar. „Effizienz ist die neue Kapazität“, sagte Zheng.
Dr. Jakob Jung ist Chefredakteur Security Storage und Channel Germany. Er ist seit mehr als 20 Jahren im IT-Journalismus tätig. Zu seinen beruflichen Stationen gehören Computer Reseller News, Heise Resale, Informationweek, Techtarget (Storage und Datacenter) sowie ChannelBiz. Darüber hinaus ist er für zahlreiche IT-Publikationen freiberuflich tätig, darunter Computerwoche, Channelpartner, IT-Business, Storage-Insider und ZDnet. Seine Themenschwerpunkte sind Channel, Storage, Security, Datacenter, ERP und CRM.
Kontakt – Contact via Mail: jakob.jung@security-storage-und-channel-germany.de