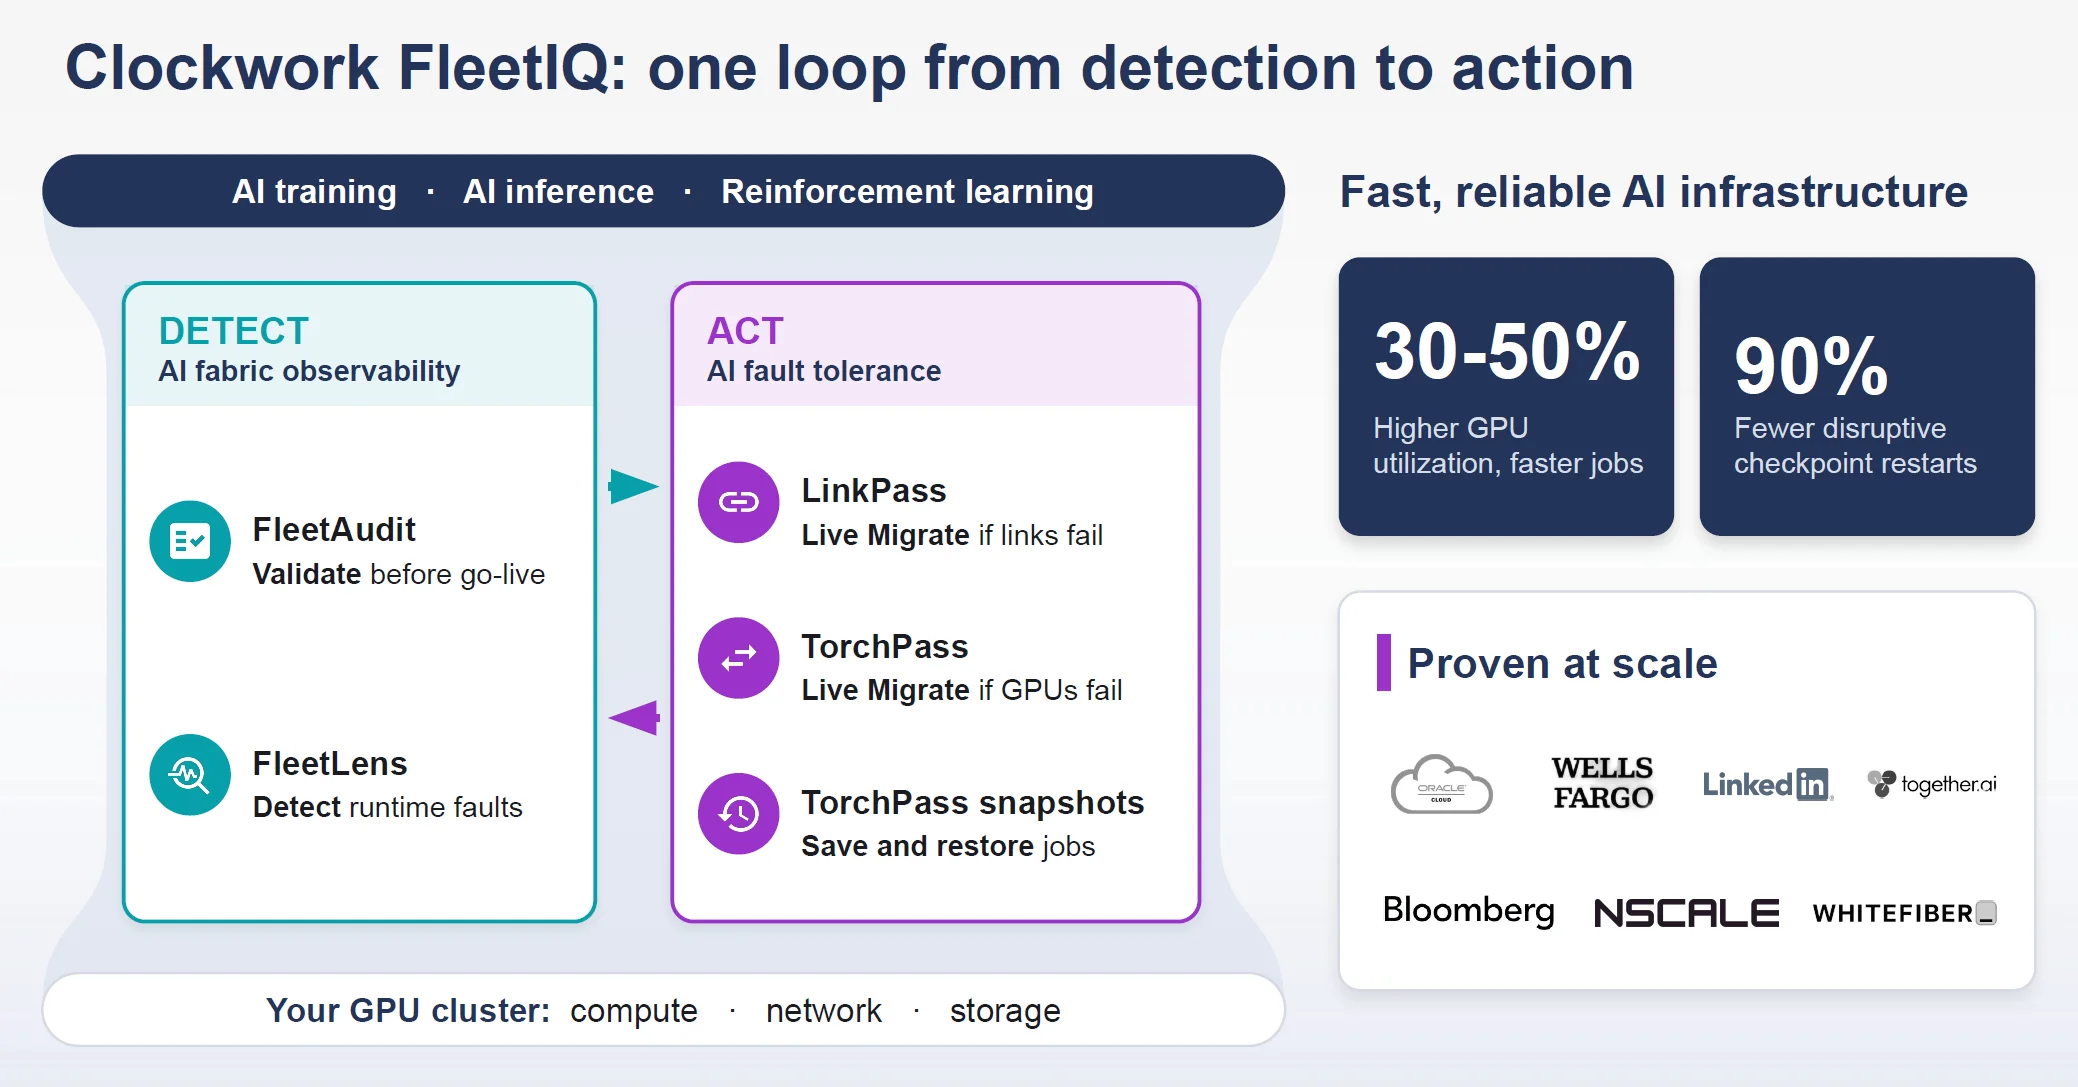
En la IT Press Tour, Clockwork.io cortó las conexiones de red y de alimentación de un entrenamiento en marcha. Según la empresa, LinkPass y TorchPass mantienen esos trabajos activos; una ronda de 31 millones financia su despliegue.
Cuando falla una sola GPU o un enlace de red entre miles, el entrenamiento de IA suele detenerse por completo. Clockwork.io quiere absorber esos fallos mediante software. En la IT Press Tour, la empresa mostró en directo cómo: sus ingenieros desconectaron un cable de red y después un cable de alimentación en pleno entrenamiento.
El coste del fallo a gran escala
Los grandes entrenamientos avanzan al unísono, de modo que un enlace caído, una GPU sobrecalentada o un nodo bloqueado paraliza a todos los participantes. El CEO Suresh Vasudevan citó un estudio de Meta que sitúa el tiempo medio hasta el fallo en 7,9 horas para trabajos con 1.024 GPU, y otro de ByteDance según el cual el 42,5 por ciento de los trabajos fue al menos un diez por ciento más lento por rezagados. Tras una caída, los equipos deben localizar el fallo, lo que a mano puede llevar de una a tres horas, reiniciar el trabajo, cargar el último punto de control y recalcular el trabajo perdido.
De la sincronización de relojes a la tolerancia a fallos
La empresa nació de un proyecto de Stanford sobre sincronización de relojes, dirigido por Balaji Prabhakar y Yilong Geng, con la participación temprana de Mendel Rosenblum, fundador de VMware. Según la compañía, el software alcanza una precisión de decenas de nanosegundos sin hardware especial, lo que le dio clientes financieros como Nasdaq y Wells Fargo. Desde 2022 esos mismos relojes sirven para la telemetría de red en clústeres de GPU; la plataforma FleetIQ está disponible con carácter general desde septiembre de 2025.
Tres capas de protección
Primero actúa LinkPass, un complemento de NCCL. Si falla una tarjeta de red, desvía el tráfico, incluidos los paquetes en tránsito, a las tarjetas sanas del mismo servidor y vuelve atrás cuando el enlace se recupera. La detección tarda cientos de milisegundos y el cambio completo, de uno a dos segundos; el tiempo de espera de transporte de NCCL ronda el minuto y el valor por defecto de PyTorch son diez minutos. En la demostración, el cable desconectado en un trabajo de dos nodos solo provocó una breve caída y el contador de pasos siguió avanzando; tras reconectar, el tráfico volvió a repartirse entre las cuatro tarjetas. La demostración se hizo en directo en el laboratorio de la empresa, no con una grabación. Vasudevan cifra entre un 15 y un 20 por ciento los fallos causados por enlaces. LinkedIn cuenta decenas de miles de horas de GPU ahorradas al mes y Oracle integra LinkPass en su nube. Dan Zheng, Chief Business Officer, añadió una ventaja operativa: el mantenimiento de conmutadores obligaba antes a avisar a los responsables de los trabajos para que guardaran puntos de control, y ahora puede hacerse con independencia de los trabajos.
TorchPass cubre GPU y nodos averiados mediante migración en vivo a un nodo de reserva, que Vasudevan comparó con vMotion. Detiene el trabajo en un punto consistente, solicita un reemplazo al planificador (Kubernetes, Slurm y variantes) y transfiere el estado. Ante fallos repentinos reconstruye el estado desde una réplica con paralelismo de datos, por lo que esta debe existir. Cuando el equipo cortó la corriente a un nodo, el trabajo se detuvo cerca de un minuto en el paso 5.040 y continuó en el mismo paso. Las reservas suelen suponer entre el cinco y el ocho por ciento del clúster y ejecutan tareas de baja prioridad hasta que se necesitan. Además de los fallos, la migración puede sacar trabajos de un nodo para aplicar parches de seguridad o eliminar rezagados, y reaccionar a avisos como el aumento de temperatura de las GPU.
La tercera capa, presentada como las primeras instantáneas de plataforma multinodo del sector, guarda el estado de CPU y GPU sin cambiar el código. La empresa afirma que tardan menos de 20 segundos y cuestan alrededor del uno por ciento con un intervalo de 25 minutos, pero exigen mucho almacenamiento y aún no se han medido los tiempos de restauración. Together AI prevé ofrecer LinkPass y TorchPass como servicio a sus clientes, con las instantáneas a continuación.
Cifras que conviene leer con cautela
En una prueba de la propia empresa, un modelo Llama 4 MoE con 64 GPU necesitó unos 400 minutos sin fallos. Con fallos inyectados cada hora, TorchPass también requirió unos 400 y el reinicio desde punto de control unos 800. La calculadora ClusterMAX de SemiAnalysis, con valores por defecto para un clúster de 4.096 GPU, muestra que la pérdida de goodput baja del 13,7 al 2,8 por ciento en un nivel oro y del 28,5 al 10,3 por ciento en uno plata. Son escenarios aportados por el fabricante, no mediciones de campo.
Observabilidad y modelo de negocio
FleetLens envía sondas entre todos los pares de tarjetas de red cada diez milisegundos y mide el retardo unidireccional con relojes sincronizados. La triangulación señala el enlace defectuoso o descarta la red. FleetAudit aplica esto antes de la entrega; WhiteFiber lo usa para validar clústeres y habla de minutos en lugar de días de pruebas. En un piloto en una gran nube de GPU, los contadores de los conmutadores, promediados a 30 o 60 segundos, parecían normales, mientras que las sondas revelaron un enlace defectuoso entre leaf y spine que afectaba a un solo trabajo.
Se cobra por GPU y año. Las neoclouds compran directamente y las empresas llegan cada vez más a través de socios como Together AI. Se admiten GPU de NVIDIA y AMD, InfiniBand y RoCE, pero no TPU ni Trainium. Vasudevan ve el principal rival en las soluciones internas de reinicio desde punto de control y dijo que la empresa abona créditos a los clientes si se recuperan sin recálculo menos del 90 por ciento de los fallos. Una ronda de 31 millones de dólares, liderada por Premji Invest, Wing y Seligman Ventures, eleva la financiación total a 73 millones de dólares. «La eficiencia es la nueva capacidad», dijo Zheng.
El Dr. Jakob Jung es redactor jefe de Security Storage y Channel Germany. Lleva más de 20 años trabajando en el periodismo especializado en TI. A lo largo de su carrera ha colaborado con Computer Reseller News, Heise Resale, Informationweek, Techtarget (almacenamiento y centros de datos) y ChannelBiz. Además, colabora como freelance con numerosas publicaciones del sector de las TI, entre las que se incluyen Computerwoche, Channelpartner, IT-Business, Storage-Insider y ZDnet. Sus temas principales son el canal, el almacenamiento, la seguridad, los centros de datos, los sistemas ERP y CRM.
Contacto – Contacto por correo electrónico: jakob.jung@security-storage-und-channel-germany.de